مدلهای VLM؛ ترکیب بینایی ماشین و هوش مصنوعی برای درک تصاویر
مدلهای VLM
مقدمه
وقتی هوش مصنوعی تصاویر را میفهمد
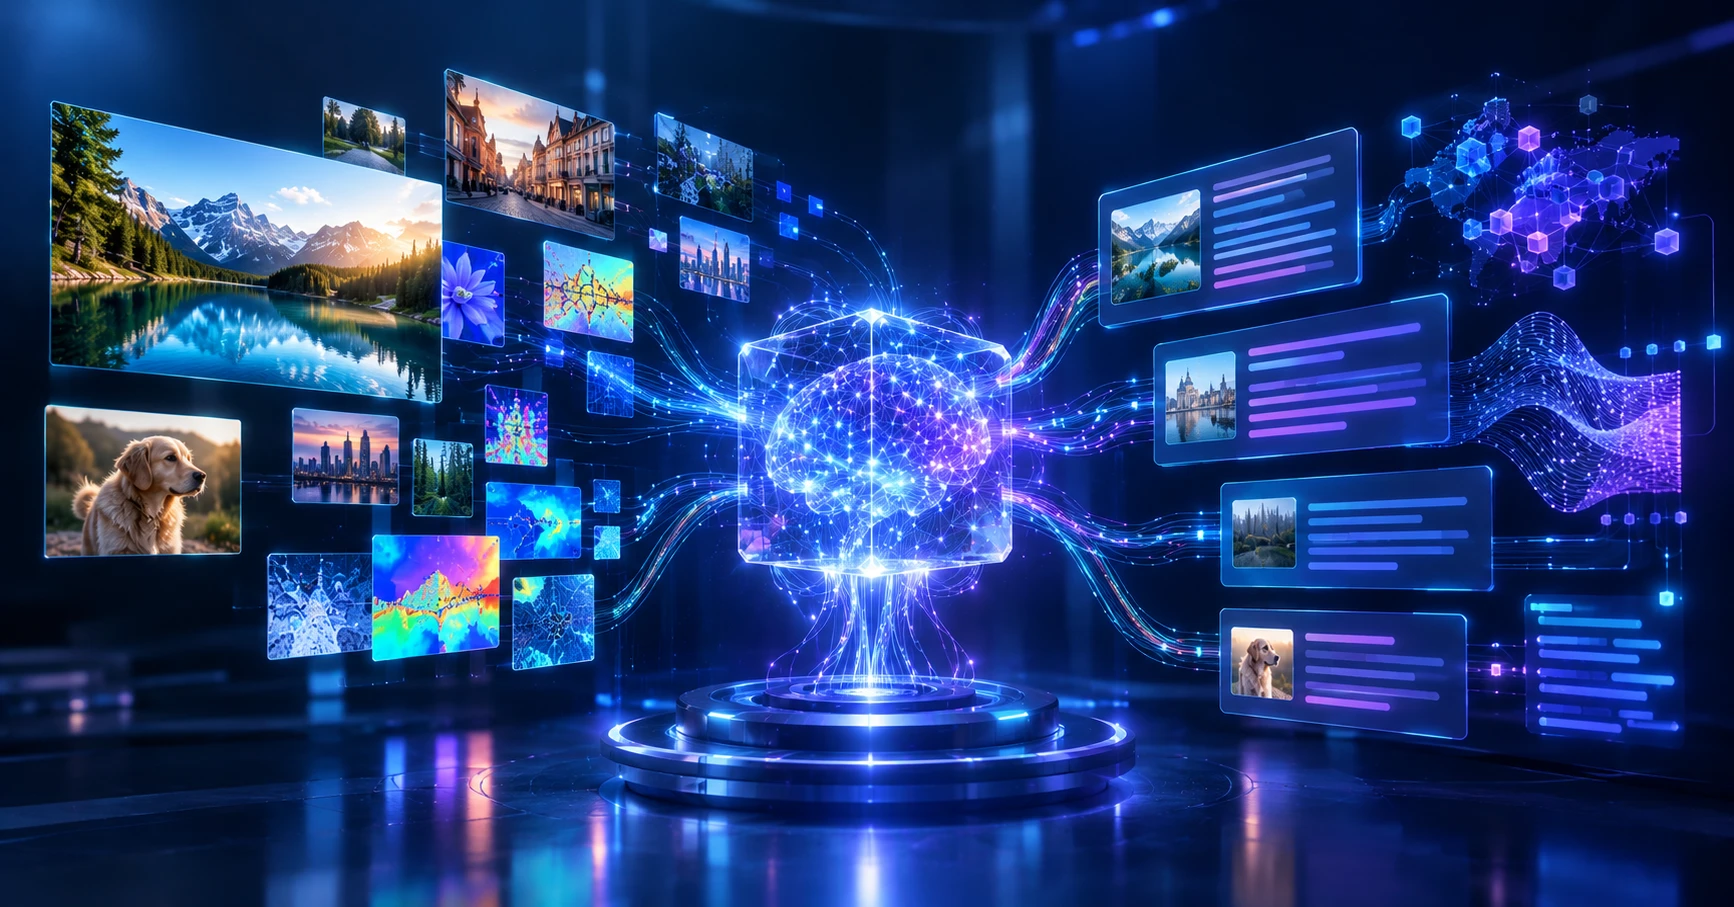
هوش مصنوعی در سالهای اخیر از پردازش متن و پاسخگویی به پرسشها فراتر رفته و به سمت درک همزمان اطلاعات متنی و بصری حرکت کرده است. یکی از فناوریهای مهم در این مسیر، مدلهای بیناییـزبانی یا VLM (Vision-Language Models) هستند که به سیستمهای هوشمند امکان میدهند تصاویر را تحلیل کنند، محتوای بصری را با زبان طبیعی توصیف کنند و به پرسشهایی درباره آنچه در تصویر دیده میشود پاسخ دهند.
در رویکردهای سنتی، بینایی ماشین معمولاً برای وظایف مشخصی مانند تشخیص اشیا، شناسایی چهره یا دستهبندی تصاویر آموزش داده میشد. اما مدلهای VLM با ترکیب قابلیتهای پردازش تصویر و زبان، امکان تعامل انعطافپذیرتری با محتوای بصری را فراهم میکنند. برای مثال، کاربر میتواند تصویری از یک محصول را به سیستم بدهد و درباره ویژگیها، اجزای تشکیلدهنده یا کاربرد آن سؤال کند.
پیشگامان لوتوس با تمرکز بر توسعه راهکارهای هوش مصنوعی و نرمافزارهای هوشمند، میتواند از ظرفیت این فناوری برای ایجاد نسل جدیدی از محصولات دیجیتال استفاده کند؛ محصولاتی که علاوه بر دریافت اطلاعات، توانایی تحلیل محتوای بصری و ارائه پاسخهای متناسب با نیاز کاربران را دارند.
مدل VLM چیست و چگونه کار میکند؟
مدل بیناییـزبانی یا VLM نوعی مدل هوش مصنوعی است که برای پردازش و ارتباط میان اطلاعات تصویری و زبانی طراحی شده است. این مدلها میتوانند محتوای یک تصویر را تحلیل کنند و اطلاعات استخراجشده را در قالب زبان طبیعی در اختیار کاربر قرار دهند. تفاوت مهم آنها با بسیاری از سیستمهای سنتی پردازش تصویر، توانایی ارتباط دادن عناصر بصری با مفاهیم زبانی و پاسخگویی به درخواستهای متنوع است.
برای درک بهتر عملکرد VLM، تصور کنید کاربری تصویری از یک میز کار را به یک دستیار هوشمند ارسال میکند. یک سیستم ساده تشخیص اشیا ممکن است وجود لپتاپ، تلفن همراه، کتاب و فنجان را شناسایی کند. در مقابل، یک مدل VLM میتواند علاوه بر شناسایی این اشیا، درباره ارتباط آنها با یکدیگر توضیح دهد، به پرسش کاربر درباره وضعیت میز پاسخ دهد یا اطلاعات مشخصی را در تصویر پیدا کند.
بسیاری از مدلهای VLM از چند جزء اصلی تشکیل میشوند. بخش بینایی، ویژگیهای بصری تصویر را استخراج میکند. بخش زبانی، متن ورودی و مفاهیم زبانی را پردازش میکند. سپس سازوکاری برای ارتباط دادن این دو نوع اطلاعات به کار گرفته میشود تا مدل بتواند بر اساس تصویر و درخواست کاربر پاسخ مناسبی تولید کند. معماری دقیق این اجزا در مدلهای مختلف یکسان نیست و بعضی از مدلها از یک مدل زبانی بزرگ در کنار رمزگذار تصویری استفاده میکنند.
برای پیشگامان لوتوس، شناخت این معماریها اهمیت زیادی دارد؛ زیرا انتخاب مدل مناسب به نوع محصول، پیچیدگی وظایف، حجم دادهها، محدودیتهای زیرساختی و سطح دقت موردنیاز بستگی دارد.
تفاوت مدلهای VLM با بینایی ماشین سنتی و مدلهای زبانی بزرگ
برای شناخت جایگاه VLM باید آن را با دو گروه مهم از فناوریهای هوش مصنوعی مقایسه کرد: سیستمهای سنتی بینایی ماشین و مدلهای زبانی بزرگ یا LLM.
سیستمهای سنتی بینایی ماشین معمولاً برای انجام یک وظیفه مشخص طراحی میشوند. برای مثال، یک مدل تشخیص اشیا میتواند خودروها را در تصاویر شناسایی کند یا یک سیستم تشخیص عیب، نواقص سطحی محصولات را پیدا کند. این سیستمها در کاربردهای تخصصی عملکرد ارزشمندی دارند، اما برای پاسخگویی به پرسشهای متنوع درباره یک تصویر ممکن است به اجزای نرمافزاری و مدلهای مکمل نیاز داشته باشند.
از سوی دیگر، مدلهای زبانی بزرگ عمدتاً برای پردازش و تولید زبان آموزش دیدهاند. آنها در خلاصهسازی متن، تحلیل اسناد، پاسخگویی به پرسشها و انجام وظایف زبانی توانمند هستند، اما یک مدل زبانی صرفاً متنی لزوماً نمیتواند محتوای تصویر را مستقیماً درک کند.
مدلهای VLM تلاش میکنند قابلیتهای این دو حوزه را به هم نزدیک کنند. آنها میتوانند اطلاعات تصویری را در کنار دستور متنی پردازش کنند و پاسخهایی متناسب با هر دو نوع ورودی ارائه دهند. برای نمونه، در یک سامانه فروش آنلاین، کاربر میتواند تصویر یک قطعه را ارسال کند و درباره ویژگیهای ظاهری آن سؤال بپرسد.
بااینحال، VLM همیشه جایگزین بهتری برای مدلهای تخصصی بینایی ماشین نیست. در وظایفی که به اندازهگیری دقیق، تشخیص صنعتی با محدودیتهای سختگیرانه یا خروجیهای کاملاً ساختاریافته نیاز دارند، ممکن است ترکیب VLM با مدلهای تخصصی نتیجه قابلاعتمادتری ایجاد کند.
پیشگامان لوتوس در طراحی راهکارهای هوش مصنوعی میتواند با بررسی نیاز واقعی هر کسبوکار مشخص کند که استفاده از VLM بهتنهایی مناسبتر است یا ترکیب آن با مدلهای تخصصی و زیرساخت نرمافزاری موجود، ارزش بیشتری ایجاد میکند.
کاربردهای مدلهای VLM در کسبوکارها
یکی از مهمترین ویژگیهای مدلهای VLM، قابلیت استفاده از آنها در طیف گستردهای از محصولات دیجیتال است. این مدلها میتوانند تعامل کاربران با تصاویر را سادهتر کنند و در بسیاری از فرایندها، نیاز به تحلیل دستی محتوای بصری را کاهش دهند. البته میزان موفقیت هر کاربرد به کیفیت مدل، نوع تصاویر، دادههای ورودی و ارزیابی عملکرد سیستم بستگی دارد.
تحلیل تصاویر در فروشگاههای اینترنتی
در فروشگاههای آنلاین، اطلاعات محصولات معمولاً از طریق عنوان، توضیحات، دستهبندی و تصاویر ارائه میشوند. مدلهای VLM میتوانند به تحلیل تصاویر محصولات کمک کنند و ویژگیهایی مانند رنگ، شکل، جنس ظاهری یا نوع محصول را استخراج کنند. این اطلاعات میتوانند برای بهبود دستهبندی محصولات، جستوجوی تصویری و تکمیل اطلاعات اولیه کالاها مورد استفاده قرار گیرند.
برای مثال، کاربر میتواند تصویری از یک کیف را بارگذاری کند و محصولاتی با ظاهر مشابه را جستوجو کند. همچنین، سامانه میتواند با ترکیب تصویر و توضیحات متنی، نتایج مرتبطتری ارائه دهد. پیشگامان لوتوس میتواند در توسعه فروشگاههای هوشمند، این قابلیتها را با سامانههای مدیریت محصولات و جستوجوی سایت یکپارچه کند.
پردازش اسناد و استخراج اطلاعات
بسیاری از سازمانها با حجم زیادی از اسناد تصویری، فرمها، فاکتورها و گزارشهای اسکنشده سروکار دارند. مدلهای VLM میتوانند در درک ساختار بصری این اسناد، ارتباط میان بخشهای مختلف و استخراج برخی اطلاعات به سیستمهای سازمانی کمک کنند.
برای مثال، در یک فاکتور تصویری ممکن است مبلغ نهایی، تاریخ، مشخصات کالا و اطلاعات فروشنده در قسمتهای مختلف صفحه قرار گرفته باشند. یک مدل چندوجهی میتواند برای تحلیل ارتباط میان این اطلاعات به کار گرفته شود. بااینحال، در فرایندهای مالی و حقوقی حساس، صحت دادههای استخراجشده باید با روشهای اعتبارسنجی و کنترلهای تکمیلی بررسی شود.
توسعه چنین راهکارهایی با خدمات هوش مصنوعی و توسعه نرمافزارهای سازمانی پیشگامان لوتوس ارتباط دارد و میتواند به کاهش فعالیتهای تکراری و تسهیل گردش اطلاعات کمک کند.
تحلیل تصاویر در صنعت و کنترل کیفیت
در محیطهای صنعتی، بررسی تصاویر محصولات و شناسایی نشانههای احتمالی خرابی میتواند به بهبود کنترل کیفیت کمک کند. مدلهای VLM در برخی سناریوها قادرند درباره ظاهر یک قطعه توضیح دهند، ناهنجاریهای قابل مشاهده را توصیف کنند یا تصاویر را بر اساس دستورهای زبانی بررسی کنند.
برای مثال، اپراتور میتواند تصویری از یک قطعه صنعتی را ارائه دهد و از سیستم بخواهد بخشهایی را که احتمال دارد دچار آسیب شده باشند مشخص کند. بااینحال، چنین خروجیای نباید بدون ارزیابی تخصصی بهعنوان تشخیص قطعی نقص در نظر گرفته شود. در کاربردهای حساس، مدلهای اختصاصی تشخیص عیب، تصویربرداری استاندارد و آزمونهای کنترل کیفیت همچنان نقش مهمی دارند.
پیشگامان لوتوس میتواند در طراحی نمونههای اولیه این راهکارها، امکانسنجی فنی و اتصال مدلهای بینایی به نرمافزارهای عملیاتی را بررسی کند.
دستیارهای هوشمند مبتنی بر تصویر
یکی دیگر از کاربردهای مهم VLM، توسعه دستیارهایی است که علاوه بر متن، تصاویر را نیز دریافت و تحلیل میکنند. در چنین سامانهای، کاربر میتواند تصویری از یک مشکل نرمافزاری، یک دستگاه یا یک محیط فیزیکی را ارسال کند و درباره آن سؤال بپرسد.
این قابلیت میتواند تجربه استفاده از چتباتها را بهبود دهد؛ زیرا کاربر برای توضیح یک وضعیت پیچیده، دیگر مجبور نیست تمام جزئیات بصری را با کلمات توصیف کند. برای مثال، در یک سامانه پشتیبانی، کاربر میتواند تصویری از پیام خطای یک دستگاه را ارسال کند و راهنمایی اولیه دریافت کند.
پیشگامان لوتوس میتواند با ترکیب VLM، مدلهای زبانی و پایگاه دانش اختصاصی کسبوکار، دستیارهایی طراحی کند که پاسخهای خود را بر اساس محتوای تصویر و اطلاعات معتبر سازمان ارائه دهند.
نقش VLM در توسعه محصولات هوشمند و تجربه کاربری
مدلهای VLM تنها ابزارهایی برای تحلیل تصویر نیستند؛ آنها میتوانند نحوه تعامل کاربران با محصولات دیجیتال را نیز تغییر دهند. در رابطهای کاربری سنتی، کاربران معمولاً برای پیدا کردن اطلاعات باید از منوها، فیلترها و فرمهای مشخص استفاده کنند. اما در یک محصول مبتنی بر VLM، امکان تعامل از طریق تصویر و زبان طبیعی نیز فراهم میشود.
برای مثال، در یک سامانه مدیریت تجهیزات، کاربر میتواند تصویر یک دستگاه را ارسال کند و درباره مشخصات ظاهری آن سؤال بپرسد. در یک اپلیکیشن خرید، میتواند تصویری از محصول موردنظر خود ارائه دهد و گزینههای مشابه را مشاهده کند. در یک سامانه آموزشی نیز ممکن است دانشآموز تصویری از یک نمودار یا مسئله ارسال کند و توضیح مرتبط دریافت کند.
این تغییر به معنای حذف طراحی رابط کاربری نیست؛ بلکه نشان میدهد رابطهای آینده میتوانند علاوه بر عناصر بصری و مسیرهای تعاملی متداول، قابلیتهای چندوجهی نیز داشته باشند. طراحان باید مشخص کنند که در چه موقعیتهایی تعامل تصویری مفید است، چه زمانی ارائه پاسخ متنی مناسبتر خواهد بود و چگونه میتوان از نمایش پاسخهای نامطمئن جلوگیری کرد.
در این زمینه، خدمات طراحی محصول UI/UX پیشگامان لوتوس میتواند در شناسایی نیازهای کاربران، طراحی مسیرهای تعاملی، ارزیابی نمونههای اولیه و کاهش پیچیدگی استفاده از قابلیتهای هوش مصنوعی نقش داشته باشد.
از طرف دیگر، توسعه چنین محصولاتی نیازمند معماری نرمافزاری مناسب است. مدیریت تصاویر ورودی، کنترل حجم دادهها، اتصال به مدل، نمایش پاسخ، مدیریت خطا و حفظ امنیت اطلاعات باید در طراحی سیستم در نظر گرفته شوند. پیشگامان لوتوس میتواند با ترکیب طراحی محصول و توسعه نرمافزار، این اجزا را در قالب یک تجربه کاربری یکپارچه پیادهسازی کند.
چالشها و محدودیتهای مدلهای VLM
با وجود قابلیتهای گسترده، مدلهای VLM بدون محدودیت نیستند. استفاده موفق از این فناوری مستلزم شناخت نقاط ضعف آن و طراحی سازوکارهایی برای کنترل خطاهاست. نادیده گرفتن این مسائل میتواند باعث کاهش اعتماد کاربران و ایجاد مشکلات عملیاتی شود.
خطا در تفسیر تصاویر: ممکن است مدل برخی جزئیات را اشتباه تشخیص دهد، اشیای مشابه را با یکدیگر اشتباه بگیرد یا درباره بخشهایی از تصویر که وضوح کافی ندارند، پاسخ نادرستی ارائه کند. در نتیجه، خروجی مدل نباید در همه شرایط معادل مشاهده مستقیم و قطعی در نظر گرفته شود.
توهم در پاسخهای تولیدشده: مدل ممکن است اطلاعاتی را با اطمینان بیان کند که مستقیماً از تصویر قابل اثبات نیستند. برای مثال، ممکن است از ظاهر یک محصول، ویژگی فنیای را نتیجهگیری کند که در تصویر دیده نمیشود. طراحی سیستم باید میان اطلاعات قابل مشاهده، استنباطهای احتمالی و دادههای تأییدشده تفاوت قائل شود.
هزینه محاسباتی و سرعت پردازش: پردازش تصاویر با وضوح بالا و اجرای مدلهای چندوجهی بزرگ میتواند به منابع محاسباتی قابلتوجهی نیاز داشته باشد. این مسئله در محصولاتی که تعداد زیادی درخواست دریافت میکنند، اهمیت بیشتری پیدا میکند. انتخاب مدل سبکتر، کاهش اندازه ورودی، پردازش مرحلهای و استفاده از زیرساخت متناسب با نیاز، از راهکارهای قابل بررسی هستند.
حریم خصوصی و امنیت دادهها: تصاویر ممکن است حاوی اطلاعات شخصی، اسناد محرمانه یا جزئیات حساس سازمانی باشند. بنابراین، پیش از ارسال تصاویر به سرویسهای خارجی باید الزامات امنیتی، محل پردازش دادهها، سیاست نگهداری اطلاعات و سطح دسترسیها بررسی شوند.
وابستگی به نوع داده و کاربرد: عملکرد یک مدل ممکن است در تصاویر عمومی مناسب باشد، اما در حوزههای تخصصی مانند پزشکی، صنعت یا بررسی اسناد حقوقی بهاندازه کافی دقیق نباشد. پیشگامان لوتوس برای طراحی راهکارهای مبتنی بر VLM باید نوع داده، معیارهای ارزیابی و پیامدهای احتمالی خطا را از ابتدا مشخص کند.
به همین دلیل، پیادهسازی حرفهای VLM تنها به انتخاب یک مدل قدرتمند محدود نمیشود؛ بلکه به ارزیابی مستمر، کنترل کیفیت، طراحی مناسب زیرساخت و تعیین حدود مسئولیت سیستم نیز نیاز دارد.
آینده مدلهای VLM و فرصتهای پیش روی کسبوکارها
پیشرفت مدلهای چندوجهی میتواند مسیر توسعه نرمافزارهای هوشمند را تغییر دهد. یکی از جهتگیریهای مهم این حوزه، حرکت به سمت مدلهایی است که علاوه بر تصویر و متن، ورودیهایی مانند ویدئو و صدا را نیز پردازش میکنند. در چنین سامانههایی، هوش مصنوعی میتواند اطلاعات چند منبع را کنار یکدیگر قرار دهد و درک جامعتری از موقعیت ارائه کند.
برای مثال، یک سیستم تحلیل ویدئو ممکن است بتواند رویدادهای قابل مشاهده را خلاصه کند، تغییرات محیط را توضیح دهد یا به پرسشهایی درباره بخشهای مختلف یک ویدئو پاسخ دهد. بااینحال، توانایی واقعی چنین سامانههایی به معماری مدل، کیفیت دادهها و محدودیتهای زمانی و محاسباتی وابسته است.
یکی دیگر از مسیرهای مهم، ترکیب مدلهای VLM با پایگاههای دانش و سیستمهای بازیابی اطلاعات است. در این معماری، مدل میتواند محتوای تصویر را تحلیل کند و برای پاسخگویی دقیقتر از اطلاعات مستند سازمان استفاده کند. چنین ترکیبی بهویژه برای فروشگاههای اینترنتی، سامانههای پشتیبانی، آموزش دیجیتال و نرمافزارهای سازمانی کاربرد بالقوه دارد.
همچنین، توسعه مدلهای کوچکتر و بهینهتر میتواند امکان اجرای برخی وظایف چندوجهی را روی تجهیزات محلی یا زیرساختهای اختصاصی فراهم کند. این رویکرد در شرایطی که کنترل دادهها، کاهش تأخیر یا مدیریت هزینه اهمیت دارد، قابل بررسی است؛ هرچند امکان اجرای محلی به توان پردازشی موردنیاز و اندازه مدل بستگی دارد.
برای پیشگامان لوتوس، فرصت اصلی در تبدیل این قابلیتها به راهکارهای واقعی و قابلاندازهگیری است. بررسی نیاز بازار، ساخت نمونه اولیه، آزمایش مدلها روی دادههای واقعی و ارزیابی هزینه و دقت میتواند به کسبوکارها کمک کند تا بهجای استفاده صرفاً نمایشی از هوش مصنوعی، محصولاتی متناسب با نیاز کاربران توسعه دهند.
چگونه VLM را در یک محصول نرمافزاری پیادهسازی کنیم؟
پیادهسازی مدلهای VLM زمانی ارزشمند است که از یک مسئله واقعی کسبوکار آغاز شود. انتخاب مدل پیش از مشخص شدن نیازها ممکن است به افزایش هزینه و پیچیدگی منجر شود؛ درحالیکه یک فرایند مرحلهای میتواند ریسک اجرای پروژه را کاهش دهد.
مرحله اول: شناسایی مسئله و تعریف کاربرد
در ابتدا باید مشخص شود که مدل قرار است چه وظیفهای انجام دهد. تحلیل تصاویر محصولات، پاسخگویی به پرسشهای تصویری، پردازش اسناد و تشخیص ناهنجاری، نیازمندیهای یکسانی ندارند. پیشگامان لوتوس میتواند در مرحله امکانسنجی، نیازهای کسبوکار و معیارهای موفقیت پروژه را مشخص کند.
مرحله دوم: انتخاب و ارزیابی مدل
در این مرحله، مدلهای موجود بر اساس دقت، سرعت، هزینه، زبانهای مورد پشتیبانی، محدودیتهای استفاده و الزامات امنیتی مقایسه میشوند. ارزیابی باید با مجموعهای از تصاویر واقعی و پرسشهای مرتبط با کاربرد موردنظر انجام شود، نه صرفاً بر اساس نتایج عمومی یا نمونههای تبلیغاتی.
مرحله سوم: توسعه نمونه اولیه
پس از انتخاب گزینههای مناسب، میتوان نمونه اولیهای ساخت که تصویر را دریافت کند، آن را به مدل ارسال کند و پاسخ را در اختیار کاربر قرار دهد. این نمونه باید مسیرهای خطا، ورودیهای نامعتبر و شرایطی را که مدل قادر به پاسخگویی قابلاعتماد نیست نیز پوشش دهد.
مرحله چهارم: یکپارچهسازی با نرمافزار
در این مرحله، مدل به رابط کاربری، پایگاه داده، سامانه احراز هویت و سایر اجزای موردنیاز متصل میشود. پیشگامان لوتوس میتواند از ظرفیت توسعه نرمافزارهای پیچیده و سازمانی برای ایجاد این یکپارچگی استفاده کند. همچنین، محدودیت دسترسیها و سیاستهای نگهداری تصاویر باید بهصورت مشخص تعریف شوند.
مرحله پنجم: پایش و بهبود عملکرد
پس از راهاندازی، کیفیت پاسخها، زمان پردازش، هزینه هر درخواست و میزان رضایت کاربران بررسی میشود. در صورت مشاهده خطاهای پرتکرار، میتوان تنظیمات مدل، کیفیت ورودیها، دستورهای متنی و فرایند اعتبارسنجی را بهبود داد.
این رویکرد مرحلهای به کسبوکارها کمک میکند تا پیش از سرمایهگذاری گسترده، ارزش واقعی مدلهای VLM را در شرایط عملی بسنجند. پیشگامان لوتوس نیز میتواند بر اساس نیاز پروژه، راهکار مناسب را از مرحله امکانسنجی تا توسعه و استقرار نرمافزار بررسی کند.
نتیجهگیری
VLMها چگونه درک بصری را به قابلیت نرمافزاری تبدیل میکنند؟
مدلهای بیناییـزبانی یکی از مسیرهای مهم توسعه هوش مصنوعی چندوجهی هستند که امکان پردازش همزمان اطلاعات تصویری و زبانی را فراهم میکنند. این مدلها میتوانند در تحلیل تصاویر محصولات، پردازش اسناد، توسعه دستیارهای هوشمند و بهبود تجربه کاربری نقش داشته باشند و راههای تازهای برای تعامل با نرمافزارها ایجاد کنند.
بااینحال، استفاده مؤثر از این فناوری به شناخت محدودیتهای مدل، انتخاب معماری مناسب، ارزیابی کیفیت پاسخها و رعایت الزامات امنیتی وابسته است. در بسیاری از کاربردهای تخصصی، ترکیب VLM با مدلهای اختصاصی و سیستمهای اعتبارسنجی میتواند راهکار مطمئنتری ایجاد کند.
پیشگامان لوتوس با تمرکز بر توسعه هوش مصنوعی، طراحی محصول و پیادهسازی نرمافزارهای پیچیده، میتواند به کسبوکارها کمک کند تا ظرفیت مدلهای VLM را متناسب با نیازهای واقعی خود ارزیابی کنند. هدف نهایی، صرفاً استفاده از یک فناوری جدید نیست؛ بلکه توسعه محصولاتی است که با تحلیل بهتر اطلاعات بصری، فرایندهای کاری را سادهتر و تجربه کاربران را هوشمندتر میکنند.
مقالههای ما:"VLM چیست و چه فرقی با LLM دارد؟ راهنمای کامل و عمیق از پایه تا پیشرفته"
بلاگهای مشابه
جعل صدا با هوش مصنوعی؛ روشهای تشخیص دیپفیک صوتی و مقابله با کلاهبرداری
عاملهای هوشمند مبتنی بر AGI؛ آینده اتوماسیون و تصمیمگیری مستقل
شبیهسازی صدا با هوش مصنوعی؛ فرصتهای تجاری و تهدیدهای امنیتی
قصد انجام پروژه خاصی را دارید؟
اگر میخواهید وبسایتی منحصربهفرد، متناسب با نیازهای خاص خودتان داشته باشید، یا اگر گمان میکنید داشتن یک اپلیکیشن موبایلی اهداف کسبوکارتان را محقق میکند، یا اگر هنوز نمیدانید چه محصولی برای پیادهسازی ایدهتان به کار میآید، با ما تماس بگیرید. شرکت نرمافزاری پیشگامان لوتوس با مشاوره و طراحی محصول ایدهآل، شما را در مسیر رشد کسبوکارتان همراهی میکند.